# 写在前面

介绍最近看的基于ℓp\ell_p范数主成分分析(Principal Component Analysis, PCA)的文章[1]

# 基于ℓp\ell_p范数的主成分分析

  • ℓ2\ell_2-PCA

F2(W)=12∑i=1N∥WTxi∥22=12tr(WTXXTW)F_2 (W) = \frac{1}{2}\sum_{i=1}^{N} \|W^T x_i\|_2^2 = \frac{1}{2} tr(W^T XX^T W)

  • ℓ1\ell_1-PCA

F1(W)=∑i=1N∥WTxi∥1=∑i=1N∑j=1m∣wjTxi∣F_1 (W) = \sum_{i=1}^{N} \|W^T x_i\|_1 = \sum_{i=1}^{N} \sum_{j=1}^{m} |w_j^T x_i|

  • ℓp\ell_p-PCA

Fp(W)=1p∑i=1N∥WTxi∥pp=1p∑i=1N∑j=1m∣wjTxi∣pF_p (W) = \frac{1}{p} \sum_{i=1}^{N} \|W^T x_i\|_p^p = \frac{1}{p} \sum_{i=1}^{N} \sum_{j=1}^{m} |w_j^T x_i|^p

# 求解算法(m=1m=1)

# 梯度下降

对应模型

w∗=arg⁡min⁡wFp(w)=arg⁡min⁡w1p∑i=1N∣wTxi∣ps.t.wTw=1w^* = \arg\min_w F_p(w) = \arg\min_w \frac{1}{p} \sum_{i=1}^{N} |w^T x_i|^p \quad \text{s.t.} w^Tw = 1

记ai=wTxia_i = w^T x_i,则 Fp(w)=1p∑i=1N(sgn(ai)ai)pF_p (w) = \frac{1}{p} \sum_{i=1}^{N} (\text{sgn}(a_i)a_i)^p对ww的梯度为

∇w=dFp(w)dw=∑i=1NdFp(w)daidaidw=∑i=1N[sgn(ai)ai]p−1[sgn′(ai)ai+sgn(ai)]xi=∑i=1Nsgn′(ai)sgnp−1(ai)aipxi+∑i=1Nsgnp(ai)aip−1xi=2∑i=1Nδ(ai)sgnp−1(ai)aipxi+∑i=1Nsgn(ai)∣ai∣p−1xi\begin{aligned} \nabla_{w} &=\frac{d F_{p}(w)}{d w}=\sum_{i=1}^{N} \frac{d F_{p}(w)}{d a_{i}} \frac{d a_{i}}{d w} \\ &=\sum_{i=1}^{N}\left[\text{sgn}\left(a_{i}\right) a_{i}\right]^{p-1}\left[\text{sgn}^{\prime}\left(a_{i}\right) a_{i}+\text{sgn}\left(a_{i}\right)\right] x_{i} \\ &=\sum_{i=1}^{N} \text{sgn}^{\prime}\left(a_{i}\right) \text{sgn}^{p-1}\left(a_{i}\right) a_{i}^{p} x_{i}+\sum_{i=1}^{N} \text{sgn}^{p}\left(a_{i}\right) a_{i}^{p-1} x_{i} \\ &=2 \sum_{i=1}^{N} \delta\left(a_{i}\right) \text{sgn}^{p-1}\left(a_{i}\right) a_{i}^{p} x_{i}+\sum_{i=1}^{N} \text{sgn}\left(a_{i}\right)\left|a_{i}\right|^{p-1} x_{i} \end{aligned}

当ai=wTxi≠0a_i = w^T x_i \neq 0,则梯度的第一项为0,即

∇w=∑i=1Nsgn(wTxi)∣wTxi∣p−1xi\nabla_{w} = \sum_{i=1}^{N} \text{sgn}\left(w^T x_i\right)\left|w^T x_i\right|^{p-1} x_{i}

若p>1p > 1,即使存在奇异点(wTxi=0w^T x_i = 0),第一项也为0,其梯度也是良定义的(见上式)。而当p<1p < 1时需要对ww进行扰动来避免奇异情况(wTxi=0w^T x_i = 0)。

该问题可以通过最速下降法来迭代求解。

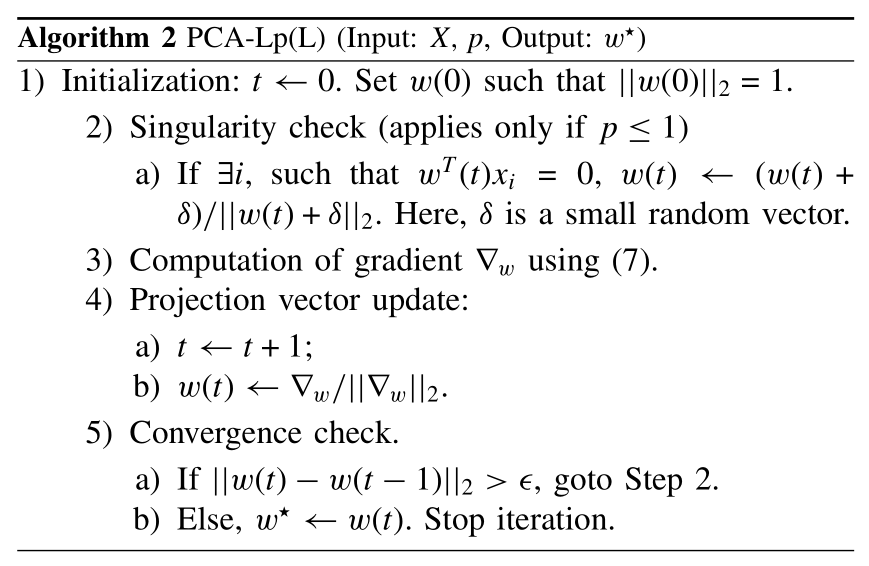
  • 初值选取
    • ℓ2\ell_2-PCA的结果
    • 具有最大范数的样本方向
  • 学习率控制收敛速率,α=0.1N\alpha = \frac{0.1}{N}
  • step 2 避免当p≤1p \leq 1时的奇异情况
  • step 5 保证规范化∥w∥2=1\|w\|_2 = 1

基于梯度下降的PCA-Lp算法

# 梯度正交向量

∇w⊥=∇w−w(wT∇w)=(Id−wwT)∇w=(Id−wwT)∑i=1Nsgn(wTxi)∣wTxi∣p−1xi\begin{aligned} \nabla_{w}^{\perp} &=\nabla_{w}-w\left(w^{T} \nabla_{w}\right)=\left(I_{d}-w w^{T}\right) \nabla_{w} \\ &=\left(I_{d}-w w^{T}\right) \sum_{i=1}^{N} \text{sgn}\left(w^{T} x_{i}\right)\left|w^{T} x_{i}\right|^{p-1} x_{i} \end{aligned}

令

ci=sgn(wTxi)∣wTxi∣p−1,vi=(Id−wwT)xi,fi=civic_i = \text{sgn}\left(w^{T} x_{i}\right)\left|w^{T} x_{i}\right|^{p-1}, v_i = \left(I_{d}-w w^{T}\right) x_{i}, f_i = c_i v_i

则

∇w⊥=∑i=1Ncivi=∑i=1Nfi\nabla_{w}^{\perp} = \sum_{i=1}^{N} c_i v_i = \sum_{i=1}^{N} f_i

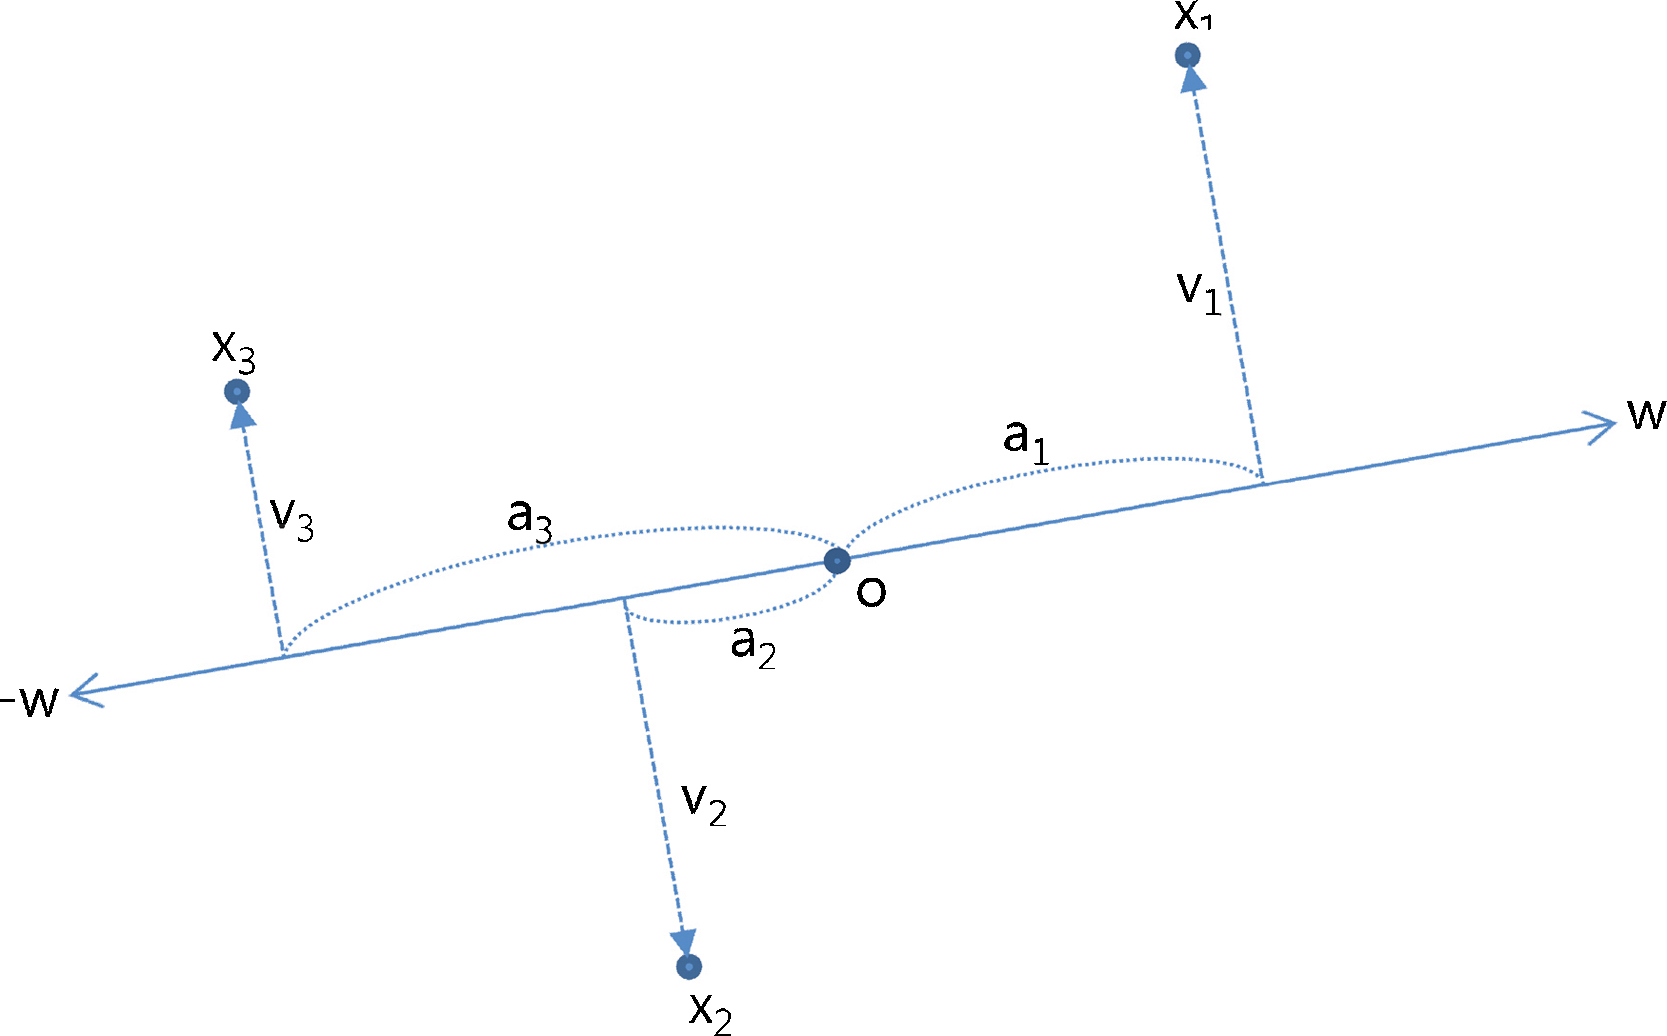
  • ai=∣wTxi∣,vi=xi−w(wTxi)a_i = |w^T x_i|,v_i = x_i - w(w^T x_i)
  • ww过原点OO旋转
  • 每一个样本 xix_i 对 ww 施加一个正交的力 fif_i
    • 当 wTxi>0w^T x_i > 0 ,点 xix_i 对 ww 产生拉力
    • 当 wTxi<0w^T x_i < 0 ,点 xix_i 对 ww 产生推力,反之对 −w-w 产生拉力
    • 力的大小为∣fi∣=aip−1∣vi∣|f_i| = a_i^{p-1}|v_i|
      • p=2p=2时,∣fi∣=ai∣vi∣|f_i| = a_i|v_i|,力收到两方面的乘积影响(拟合性)
      • p=1p=1时,∣fi∣=∣vi∣|f_i| = |v_i|,力只收到一方面的乘积影响(鲁棒性)
      • p<1p<1时,∣fi∣=(∣vi∣ai)1−p∣vi∣p|f_i| = (\frac{|v_i|}{a_i})^{1-p}|v_i|^p,aia_i对力产生负影响,从而降低异常值的干扰
      • p→0p \to 0时,∣fi∣=∣vi∣ai|f_i| = \frac{|v_i|}{a_i}

# 传统PCA联系

当p=2p = 2时

∇w=∑i=1Nsgn(wTxi)∣wTxi∣p−1xi=∑i=1NxixiTw\nabla_{w} = \sum_{i=1}^{N} \text{sgn}\left(w^T x_i\right)\left|w^T x_i\right|^{p-1} x_{i} = \sum_{i=1}^{N} x_{i} x_i^T w

∇w⊥=(Id−wwT)∑i=1Nsgn(wTxi)∣wTxi∣p−1xi=(Id−wwT)XXTw\nabla_{w}^{\perp} =\left(I_{d}-w w^{T}\right) \sum_{i=1}^{N} \text{sgn}\left(w^{T} x_{i}\right)\left|w^{T} x_{i}\right|^{p-1} x_{i} = \left(I_{d}-w w^{T}\right) XX^T w

因此优化问题可以通过协方差矩阵的特征值分解解决。而梯度正交向量有如下性质:

∇w⊥=0⟺∇w=XXTw\nabla_{w}^{\perp} = 0 \iff \nabla_{w} = XX^T w

# 拉格朗日乘子法

约束优化问题转化为如下

L(w,λ)=Fp(w)+λ(wTw−1)L(w, \lambda ) = F_p(w) + \lambda (w^T w - 1)

令拉格朗日函数导数为0可得最优解的必要性

dL(w,λ)dw=∇w+λw=0\frac{dL(w,\lambda)}{dw} = \nabla_w + \lambda w = 0

可得ww与梯度∇w\nabla_w平行,又∥w∥2=1\|w\|_2=1,因此可对ww直接更新

w←∇w∥∇w∥2w \leftarrow \frac{\nabla_w}{\|\nabla_w\|_2}

通常情况下,这种令导数为零方法取到的不仅是最大值,也有可能是最小值。因此在ℓp\ell_p-PCA里,对p≥1p \geq 1,由FpF_p的凸性可得该迭代下的目标函数非减。

Fp(wk+1)≥Fp(wk)+∇wT(wk+1−wk)≥Fp(wk)F_p(w^{k+1}) \geq F_p(w^{k}) + \nabla_w^T (w^{k+1} - w^{k}) \geq F_p(w^{k})

第二个不等号是因为∥wk+1∥2=∥wk∥2=1\|w^{k+1}\|_2 = \|w^{k}\|_2 = 1且wk+1w^{k+1}平行于∇w\nabla_w,∇wTwk+1=1\nabla_w^T w^{k+1} = 1。

基于Lagrangian乘子法的PCA-Lp算法

# 求解算法(m>1m>1)

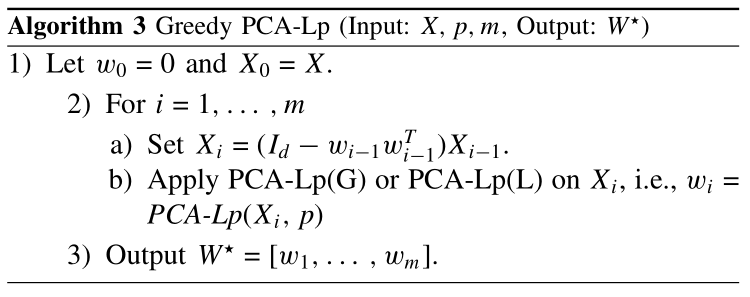
# 贪婪算法(近似求解)

  • 往往求得局部最优解,而不是全局最优解

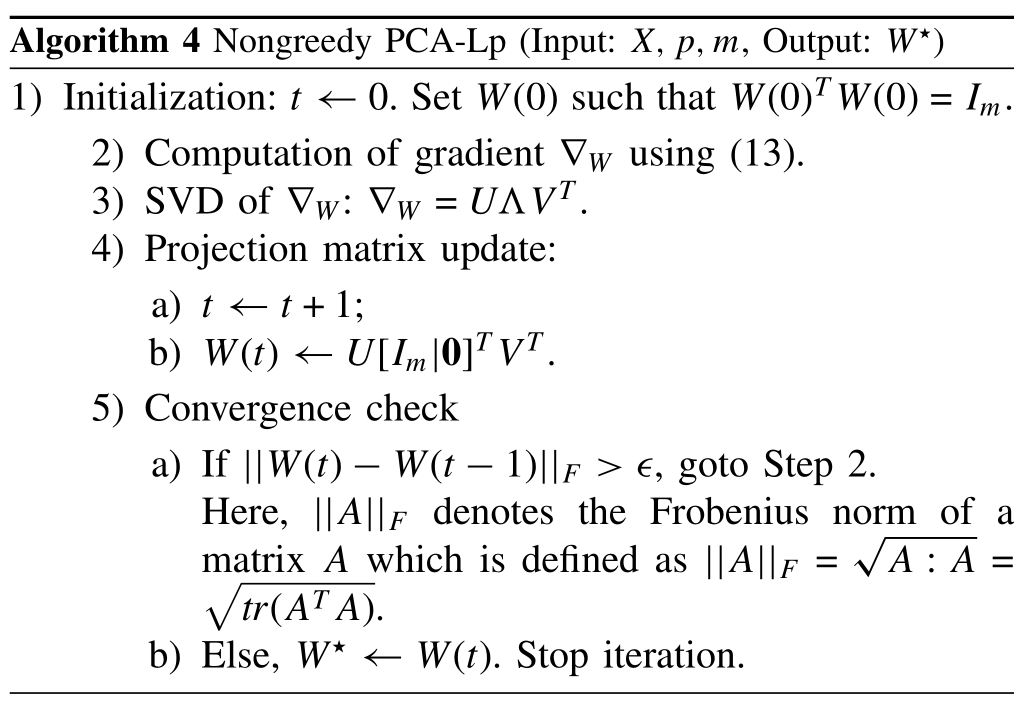
# 非贪婪解

对目标函数求梯度

∇W=dFp(W)dW=[∇w1,…,∇wm]\nabla_W = \frac{dF_p(W)}{dW} = [\nabla_{w_1},\dots,\nabla_{w_m}]

对应的拉格朗日函数为

L(W,Γm)=Fp(W)+tr(ΓmT(WTW−Im))L(W, \Gamma_m ) = F_p(W) + tr(\Gamma_m^T (W^T W - I_m))

同样的,设导数为0,即

dL(W,Γm)dW=∇W+2WΓm=0\frac{dL(W, \Gamma_m )}{dW} = \nabla_W + 2W\Gamma_m = 0

迭代不能再是简单的赋值,需满足正交约束,因此考虑如下优化问题

W∗=arg⁡max⁡Qtr(QT∇W)s.t.QTQ=ImW^* = \arg\max_Q tr(Q^T \nabla_W) \quad \text{s.t.} Q^T Q = I_m

设∇W\nabla_W的SVD分解为∇W=UΛVT\nabla_W = U\Lambda V^T,记Z=VTQTUZ = V^T Q^T U,得ZZT=Id,zii≤1ZZ^T = I_d,z_{ii}\leq 1。因此

tr(QT∇W)=tr(QTUΛVT)=tr(ΛVTQTU)=tr(ΛZ)=∑iλiizii≤∑iλii\begin{aligned} tr(Q^T \nabla_W) &= tr(Q^T U\Lambda V^T) = tr(\Lambda V^T Q^T U) \\ &= tr(\Lambda Z) = \sum_i \lambda_{ii}z_{ii} \leq \sum_i \lambda_{ii} \end{aligned}

取等号时当且仅当zii=1z_{ii} = 1,此时Z=[Im∣0]Z = [I_m | 0],最优解

W∗=UZTVT=U[Im∣0]TVTW^* = U Z^T V^T = U [I_m | 0]^T V^T

# 参考文献


  1. Kwak N. Principal component analysis by Lp-norm maximization. IEEE Trans Cybern. 2014;44(5):594-609. ↩︎